3D 视觉导论:手机视频为什么能变成 3D
你想把寝室一角做成能在网页里转着看的场景,给参赛作品当入口。站在原地举着手机转一圈,明明拍到了四面墙,为什么还可能拼不出房间?关键在于:拍到了什么,和从哪些位置拍到,是两回事。
- 读完你能解释:一张照片为什么没有直接给出物体离相机多远。
- 读完你能判断:两张照片之间,既换了拍摄位置,又保留了哪些共同细节。
- 读完你能给自己的场景安排一条拍摄路线,发现漏拍后知道往哪里补。
01照片有左右上下,却没写离你多远
假设你拍的是书桌上的花盆。照片能告诉你,叶尖落在画面的左边还是右边,却没有给它标上距离。同一条视线上的点,无论离相机近还是远,都可能落在照片的同一个位置。
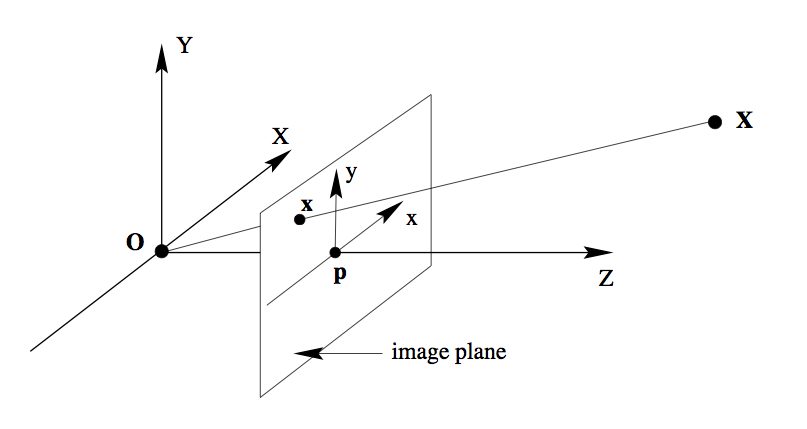
图中的 O 是相机的光心。把成像简化为光线都经过这个点,就是针孔相机模型(Pinhole Camera Model)。图里把成像平面画在光心前方,方便看投影关系;光心到这个平面的距离叫焦距(Focal Length)。
焦距变大,照片里的东西会变大;东西靠近相机,也会变大。因此,仅凭画面里的一次大小变化,还分不清是镜头变了,还是距离变了。先猜一猜:下面两种操作都能让近处的箱子放大一倍,远处的箱子也会放大一倍吗?
- 把焦距从 400 像素调到 800 像素,看两个箱子的像素高度和角上的「近/远」读数。
- 复位,再把相机前移 1.5 米(拖俯视图里的相机,或调「靠近」),比较读数。
两个同样大的箱子,近的离相机 3 米,远的 6 米。焦距从 400 像素调到 800 像素,两个箱子都放大 2 倍,近/远保持 2.0×;相机前移 1.5 米,近箱同样放大 2 倍,远箱只放大约 1.3 倍,近/远变成 3.0×。只看一个物体的大小,分不清是焦距变了还是距离变了。
只看近处的箱子,两次放大一模一样;远处的箱子和「近/远」读数才露出差别。要找回叶尖的空间位置,你还需要从别的位置看看它。
02换个位置,才能多一条深度线索
你往旁边走,再拍同一个叶尖。第一张照片给出一条视线,第二张又从另一个位置给出一条。相机参数已知、对应点找对时,就可以估计两条视线在空间中的相交位置。这叫三角测量(Triangulation)。
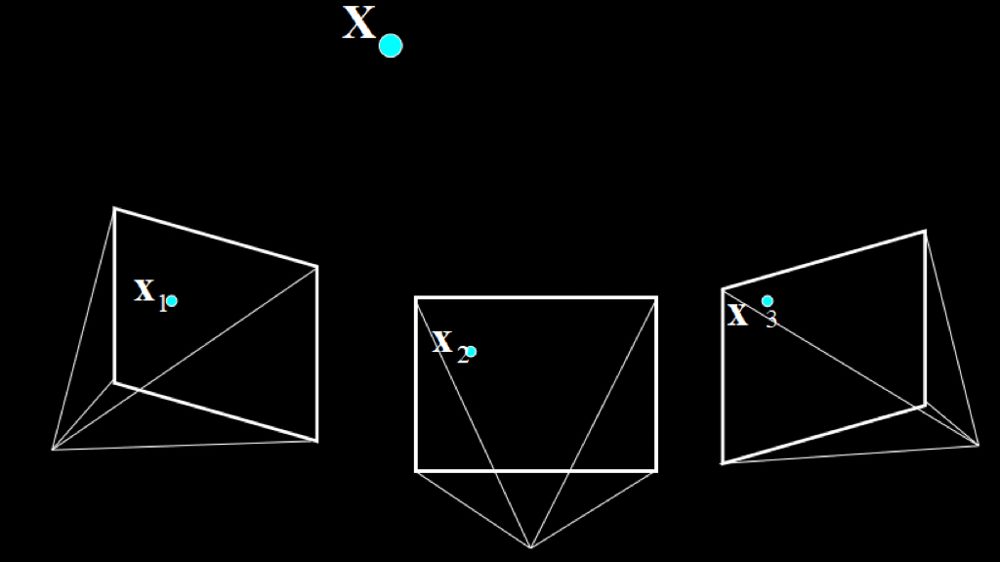
这就解释了拍摄时为什么要留重叠:相邻照片得拍到一部分相同的内容,软件才能把叶片边缘、花盆上的花纹等细节对应起来。如果前一张只拍正面,下一张突然跳到背面,没有共同细节,就很难把它们接上。
手机视频可以拆成连续的照片,为重建提供这些视角。但软件通常还不知道每张照片到底在哪里拍,要连相机的位置与朝向一起估计。这个过程叫运动恢复结构(Structure from Motion,SfM),其中的「运动」指拍摄视角变化,拍摄对象应保持静止。
三维重建工具 COLMAP 的这个广场示例,把多张照片算成了下面的结果:建筑和道路由三维点勾出,红色标记则显示拍照的位置。
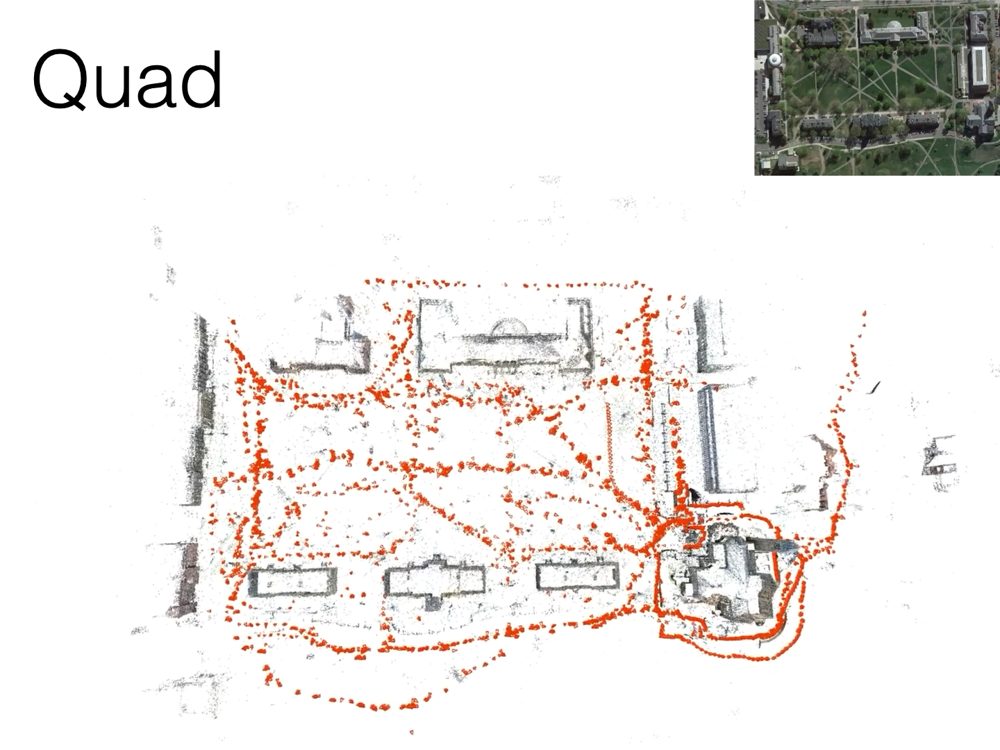
你这周不必自己求解相机位置,但要给工具留下能求解的素材:拍摄位置有变化,相邻画面又能接得上。
03给自己的作品安排一条拍摄路线
回到寝室场景。如果手机始终在一个位置,只朝四周转,虽然看到了更多方向,光心却基本没动。对同一个物理点,你仍缺少从不同位置观察得到的深度线索;在原地多拍一些帧,也补不上这段位移。
想做能换视角浏览的参赛作品,可以从一盆植物或房间一角开始,把能走的路线先看一遍:
拍花盆时,人绕着花盆走,镜头持续朝向它;拍室内时,沿可通行的边缘移动,朝空间内部拍。别只站在原地转手机。
慢慢移动,尤其别在转角突然甩镜头。拍完回放,在一段移动中暂停两次,找找同一片叶子、桌角或花纹是否仍在两张画面里。
绕到侧面和背面,检查有没有被遮住的区域。补拍时从已经拍过的区域接过去,保留共同细节,别只孤零零地补一张背面照。
已经绕着走了,为什么还有一块拼不上?
先回看那一段:是否移动太快,细节模糊了?相邻画面有没有共同内容?如果缺口正对一面没有花纹的白墙,软件也难找到稳定的对应点。可以让带纹理的桌沿、门框和墙面同时入镜,再从相邻位置补拍;同时保持光照稳定,避免人员在画面里走动。
更完整的室内与物体拍法见3DGS 手机采集。这里先记住路线为什么这样安排,免得拍完后只剩一段看着完整、却缺少多视角线索的视频。
04AI 能猜远近,拍摄还要认真吗?
如果素材只剩一张照片,模型也可以根据训练中学到的图像规律预测远近,叫单目深度估计(Monocular Depth Estimation)。下面是同一条街的照片和预测结果:先找橙色车辆,再沿路面看向远处。
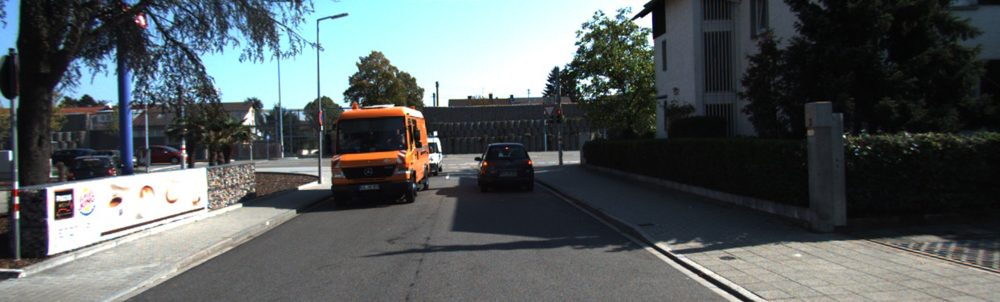
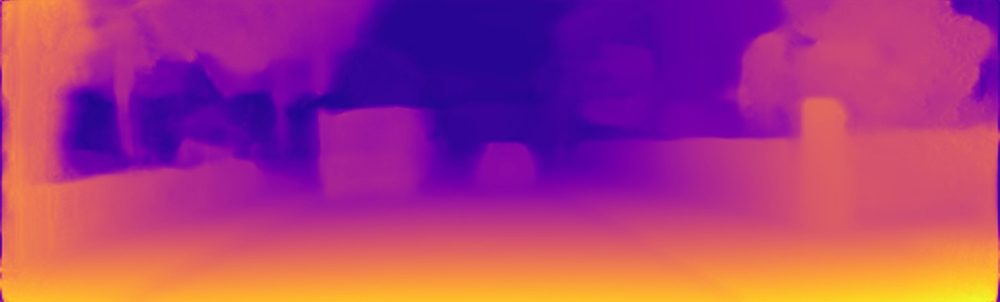
这样的输出叫深度图(Depth Map)。如果你的作品要用它量距离,先确认输出有没有实际单位,再拿已知尺寸核对;颜色层次清楚,本身不代表能直接按米测量。照片里没拍到的花盆背面,也不会因为有了这张深度图就得到真实记录。
想深入:有些模型能把多张照片一起变成 3D,做了什么?
VGGT(Visual Geometry Grounded Transformer)会把多张图像一起输入训练好的网络,联合预测相机参数、深度和三维点等信息。下面的房屋结果里,既有外墙和植物,也有周围的相机标记。
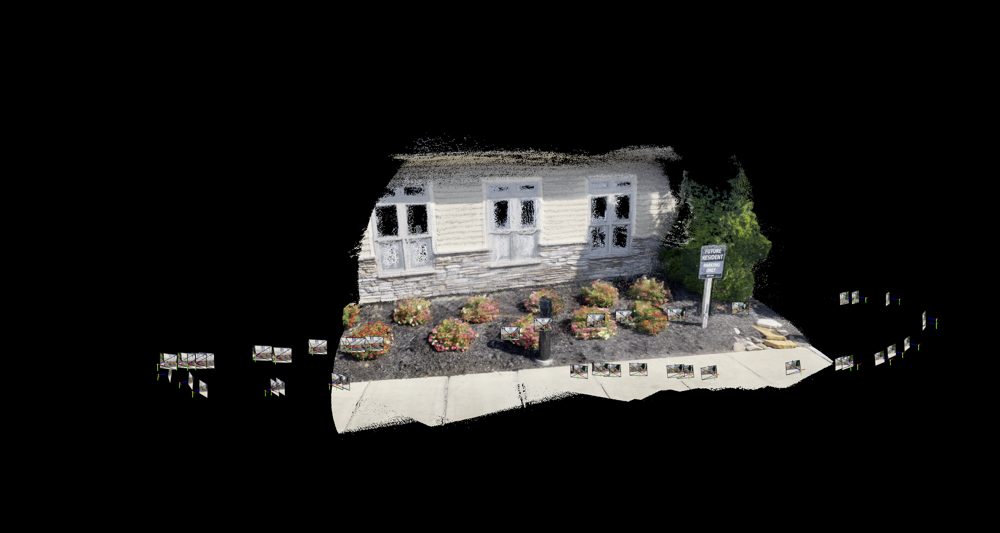
COLMAP 的优化式路线会针对当前照片反复调整相机和三维点;VGGT 这样的前馈式路线用训练好的网络直接预测,也可以再接几何优化。学习到的规律能帮助模型在缺少线索时给出结果,但给出了形状,不代表每处都测准了。
用到自己的作品时,转到侧面和背面检查有没有拉长、错位或缺块,再用实际物体核对。发现问题,优先补拍缺少观察的区域,不要把按时交作品的希望全押在模型替你补齐上。
拍摄时保留重叠、真正换位置,是你能直接改善的输入。接下来的空间重建会讲这些结果怎样存成点云、网格或 3D 高斯,哪一种适合放进网页浏览。
05自测:这段素材够不够用?
4 题已答对。接着选一种适合你作品的三维表示。
下一课 →