Day 2 · 空间理解:让作品知道物体在哪里
你想做一个房间展示网页:点一下沙发,就弹出它的介绍。AI 能告诉你「房间里有沙发」,网页却还是不知道沙发在哪、该点哪里。这一页帮你搞清楚该向 AI 要哪种识别结果,以及怎样检查它找得对不对。
读完你能:
- 按功能(自动标注、点选、抠图)选对识别结果:类别、框还是轮廓。
- 说清在三维场景里定位一件物体还需要哪些信息。
- 给自己的作品写一条能实际检查的识别要求。
01想选中一个物体,你需要什么结果?
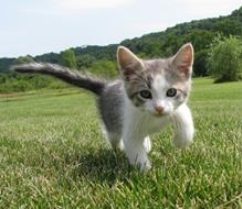
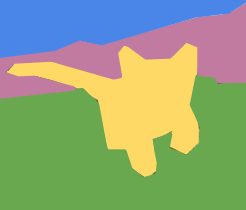
先看这张猫的照片。如果只想给图片打一个「猫」的标签,分类(Classification)就够了。如果想把猫所在的区域涂亮,就得知道哪些像素属于猫——像素就是组成图片的一个个小点。
换一张有两只狗、一只猫的照片。给每只动物画一个矩形框、标上类别,网页就能把标签放到对应位置,这叫物体检测(Object Detection)。但框里还夹着背景,想把动物抠出来,需要沿着轮廓的选区。
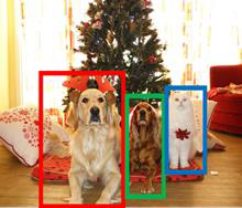
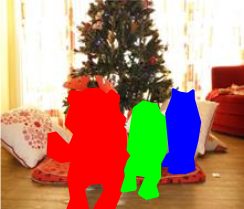
这种沿轮廓的选区叫掩码(Mask),它逐个像素记下「是不是目标」。只按类别标区域,叫语义分割(Semantic Segmentation),两只狗会被标成同一种颜色;连个体也分开,叫实例分割(Instance Segmentation)。房间里有两把椅子,你只想选中其中一把,就需要实例分割。
| 你的功能 | 要的结果 |
|---|---|
| 给图片打类别标签 | 分类:类别名称 |
| 数目标、在图片上加标注 | 检测:每个目标的类别与二维框 |
| 选出图片中所有椅子区域 | 语义分割:标为「椅子」的像素 |
| 只抠出其中一把椅子 | 实例分割:那把椅子的独立掩码 |
先猜一猜:两只狗被标成同一种颜色时,能单独抠出左边那只吗?下面给了一个任务「只把左边的狗单独抠出来」,四种结果并排摆着,看每张图底下哪一种做得到;再把目标换成右边的狗或猫比一比。
分类只给标签;检测给各自的矩形框;语义分割按类别标区域;实例分割区分每个个体。要贴合轮廓只抠左狗,应取它的实例掩码。
为自己的功能选好结果后,记得把框或掩码叠回原图检查:标签有没有贴错?轮廓有没有漏掉椅子腿?不过这些都还只是照片上的位置,放进可以转动的三维场景,又是另一回事。
02放进三维房间,名字对了还不够
照片上的框只是一张图里的范围。访客把视角转到沙发侧面,原来那个二维框就对不上了。要让标注跟着物体走,你需要知道物体在三维场景里的位置。
对比下面两张图:左边是重建出的房间点云,看得见家具的形状,但程序不知道哪些点是沙发;右边给每件家具加上了名称和三维范围,程序就能按物体查找了。像这样弄清场景里有什么、在哪里、彼此怎样摆放的能力,叫空间理解(Spatial Understanding)。
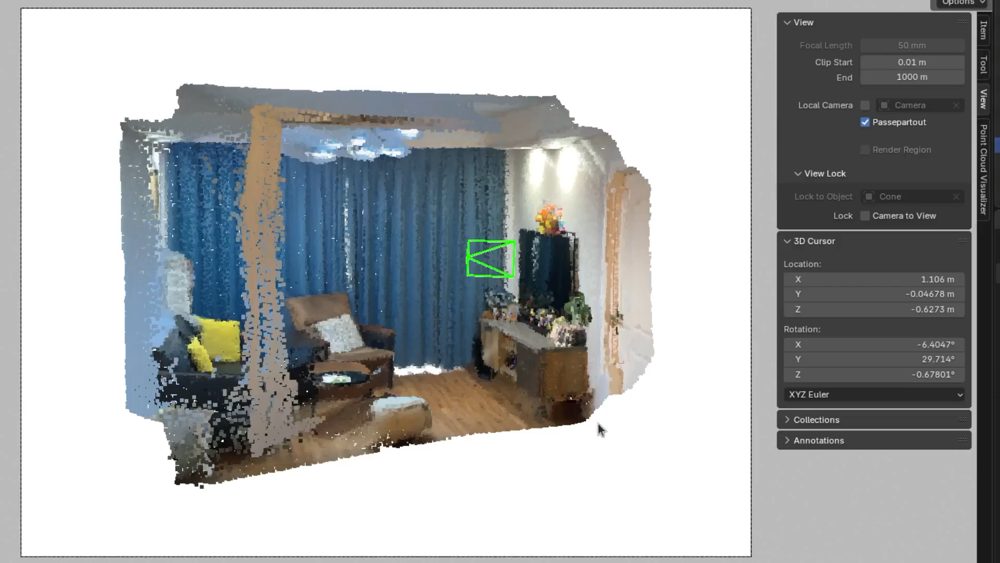
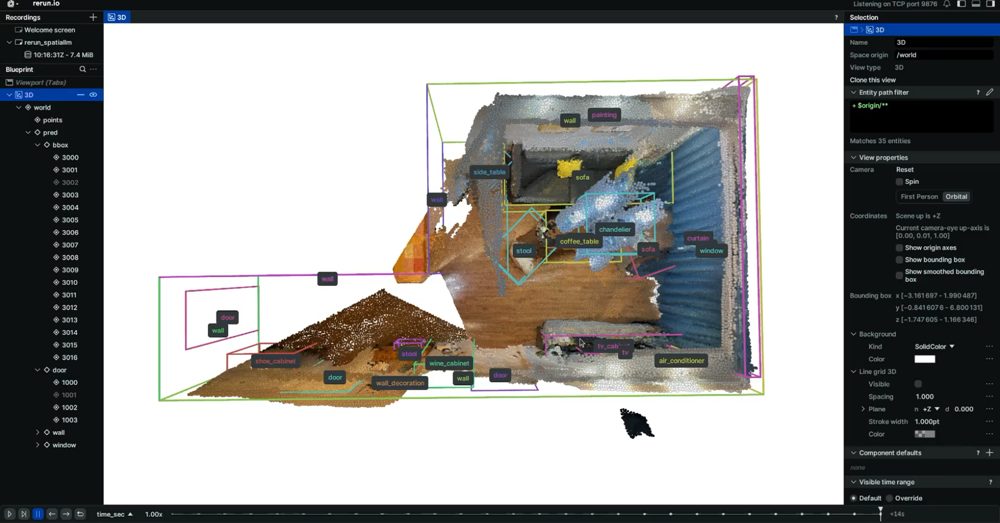
这种三维框就像套在家具外面的一个长方体,记下它的位置、长宽高和朝向。想知道沙发大致占了哪一块,用它就够了;想沿着沙发的轮廓精确点选,还需要标出沙发对应的那部分表面。
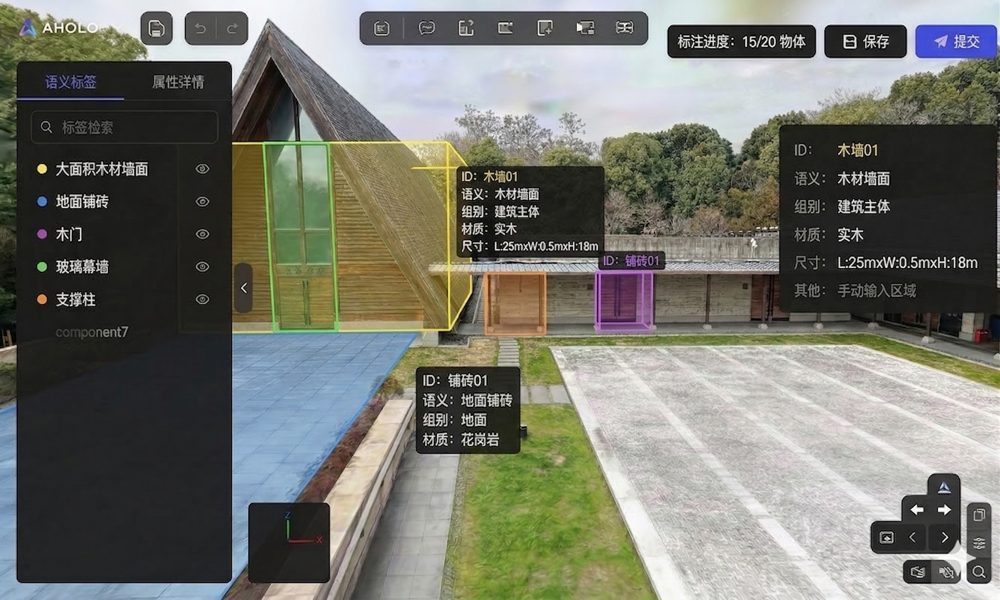
注意,AI 认对了「沙发、茶几」,也可能把它们的左右位置弄反。如果你还想判断「茶几会不会挡住门」,就得拿位置和尺寸去算,这叫空间推理(Spatial Reasoning)。光有一份家具名单,回答不了这个问题。拿到识别结果后,可以按下面三步检查:
在场景中点选家具,看名称是否对应;两把椅子要能分开。
转到侧面,看框与标注是否还跟着原物体,检查左右与朝向。
做介绍卡,就检查点选对不对;要判断挡不挡门,再去核对尺寸、距离和门打开的范围。
这周可以先做「点选家具,弹出介绍」。自动识别一时接不通,也可以先手动给几件家具加标记,把交互做出来,并在作品里写明标记是人工加的。今天给自己写一条要求,比如「转动视角后,点这把椅子仍然弹出它的介绍」,等第 4 天做网页时拿来检查。
03不想手工描边:用 SAM 选区域
如果你的作品要做局部编辑,最省事的是:点一下目标,让模型自动沿轮廓选出来。SAM(Segment Anything Model)就是做这件事的通用分割模型:你用点、框告诉它想选哪里,它返回对应的掩码。
下面是一幅画和它的分割结果。先找到左侧的人物,再看右图的轮廓有没有把人物和田地分开。这样选出来的区域,就能交给后面的编辑功能。
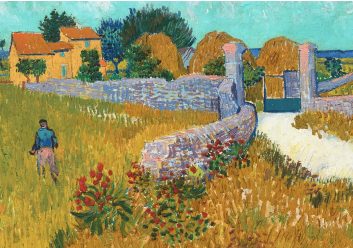
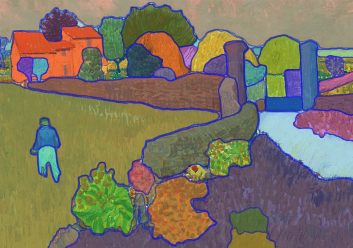
你点的位置表达「我想选哪里」,掩码显示「模型实际选了哪里」,两者不一定一致。拿到结果还是要叠回原图看边缘,不对就补点几下或者调整框。
有了掩码,就能按名字搜索物体吗?
不能。掩码只记录区域,不知道这块区域叫什么。要搜「椅子」,还需要类别标签。原版 SAM 只接受点、框这类提示;如果你的功能要用文字找东西,得选一个支持文字定位的模型。
04照片里的选区,怎样带进三维场景?
只在一张照片上选中桌面,换个视角就对不上了。想让三维网页始终知道哪些表面属于同一张桌子,可以把照片上的分割结果和重建出的三维场景结合起来。
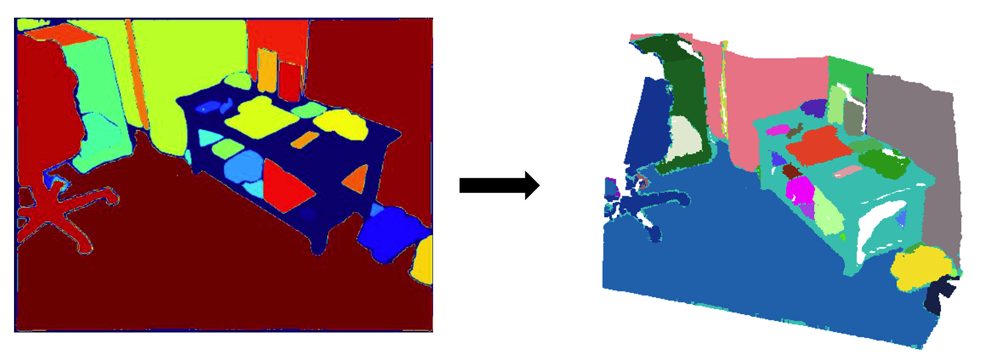
Pointcept 的 SegmentAnything3D 项目就是这样做的:先给同一场景的多张照片分别划出区域,再借助重建得到的相机位置,把每块区域对应到三维点上,最后把不同照片里属于同一件物体的区域合并起来。
难点在于对应:有的照片里椅子被挡住、漏选了,有的把同一把椅子分成了两块。检查时要转动场景,看标记是否始终落在同一件物体上。
这套流程这周不需要你自己实现,了解它能帮你判断以后要做更完整的功能时需要哪些数据。眼下先让点选的家具和介绍卡稳定对上,房间展示的小作品就完整了。