Day 2 · 空间生成:把想法变成 3D,还要转着检查
你想做一个「给寝室挑一盏灯」的小网页,让别人转着看你设计的灯。没有现成的灯可以拍,你也不会建模,能只写一句描述就开始吗?可以,生成工具就是干这个的。但正面好看还不够:转到侧面、背面,它也得是同一盏灯。
读完你能:
- 判断你的作品是要还原一件真实的东西,还是创造一件新东西。
- 转动检查一件生成的物体:形状、材质和位置关系有没有走样。
- 写好第一件资产的设计要求,明天带到 Lux3D 里试做。
01先选:还原已有的,还是创造想要的
想把自己的寝室搬进网页,和想给寝室设计一盏新灯,是两件不同的事。前者有真实的房间可以拍,后者只有你脑子里的样子。
用照片或视频还原
你拍下寝室,希望桌椅、门窗都和现实一样。这是空间重建。检查时拿实拍照片对照,看有没有漏掉或还原错的地方。
用描述或参考图创造
你描述一盏新灯的造型,或者给一张喜欢的灯的图片,让模型生成三维物体。这是空间生成。检查时对照你自己写的设计要求。
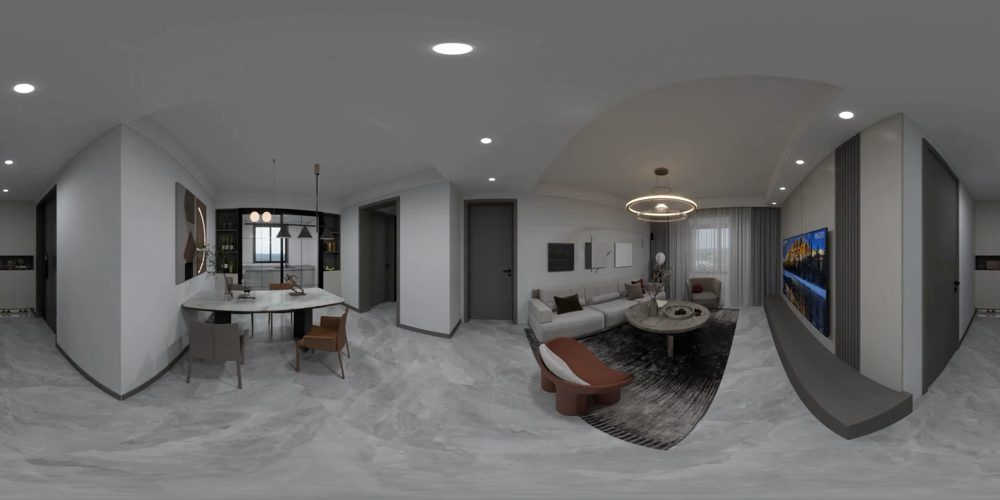
用下面这张客厅图看看区别:图里有圆环吊灯、茶几和窗帘,但拍不到镜头背后那面墙。如果你要原样还原这间房,就得去补拍那面墙;如果你只是想要一个新客厅,可以让模型把没拍到的部分补出来。
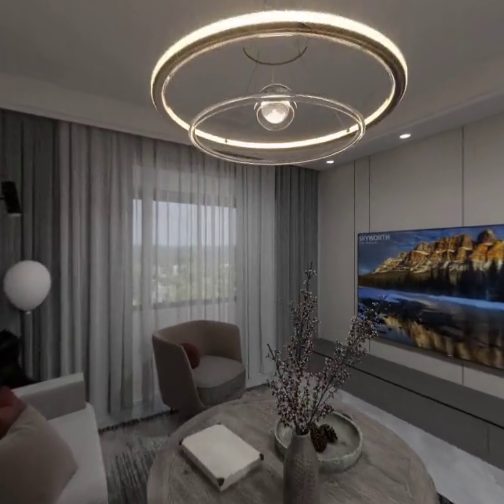
空间生成是根据文字描述或参考图,创造出三维物体、场景或材质,也包括把没拍到的部分补出来。
同理,只给一张灯的照片,灯的背面就是模型「想」出来的。做新设计时,补一个合理的背面完全没问题;但如果你要展示的是一件真实存在的灯,补出来的背面就不能当真,需要补拍或找到真实资料。
下面是这间客厅做成三维场景后的样子,可以换位置、换角度查看。
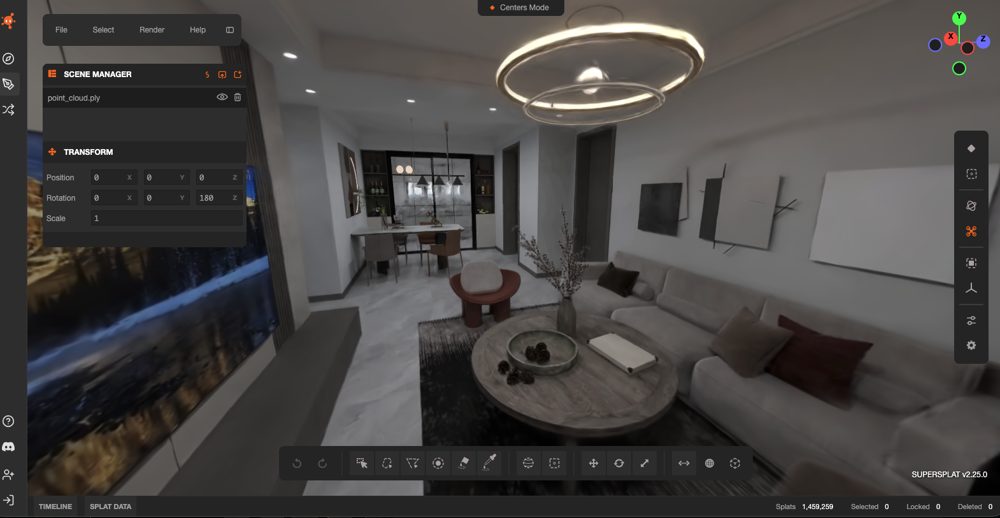
两条路也可以一起用:先重建自己的寝室,再把生成的新灯放进去。下面就是这样做的:先把一间毛坯办公室扫描还原,再往里面放进设计好的家具。
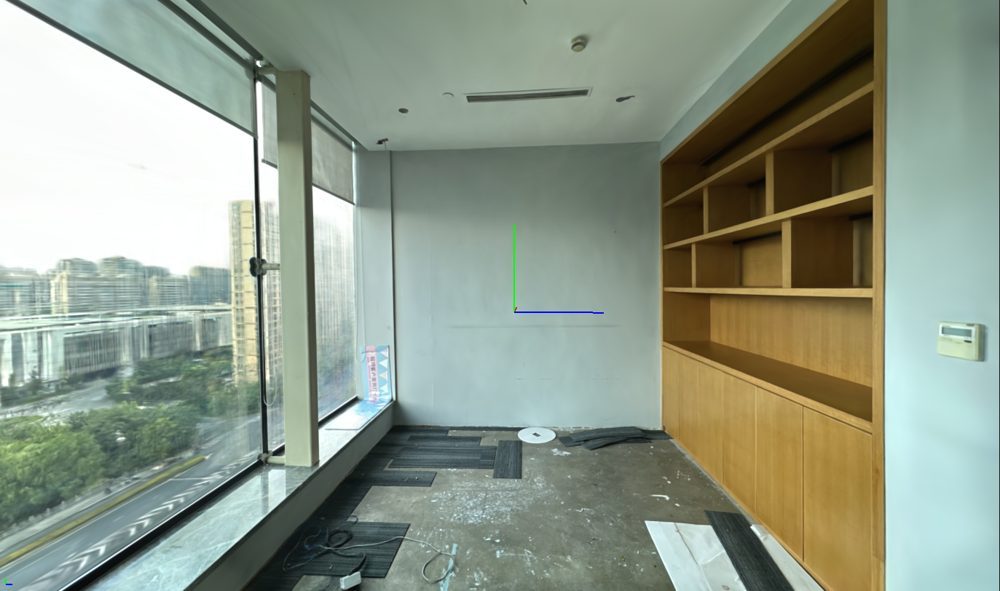
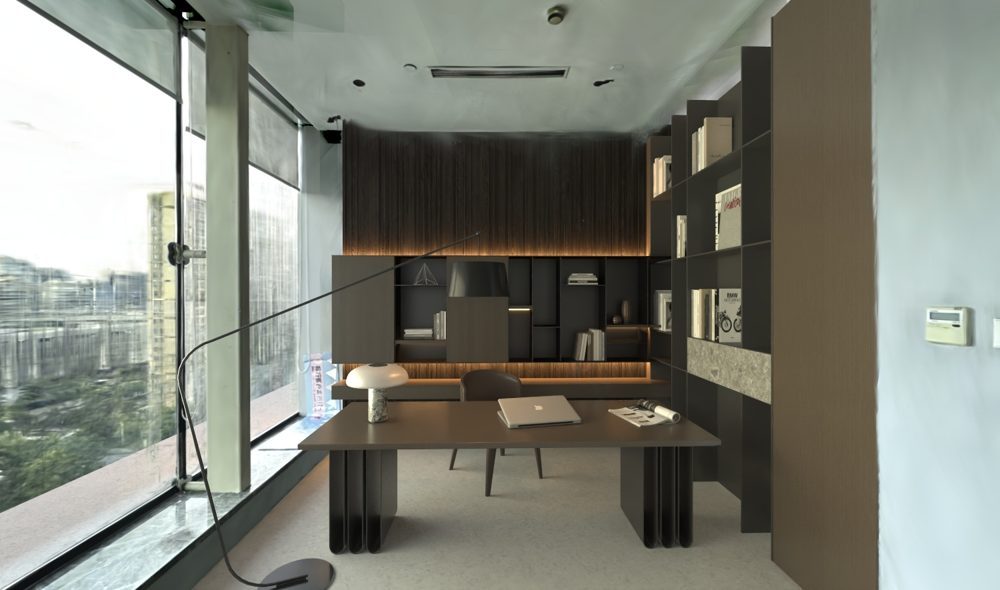
不过五天时间很紧,建议先只做一盏能转着看的灯,把造型做好,再决定要不要加上整个房间。
02转一圈,确认它还是同一件东西
生成结果正面很好看,你很想马上放进作品。先别急:别人一转视角,灯环会不会断开?背面会不会冒出一块本该只在正面的花纹?这些要在展示前检查掉。
先分清什么变化是正常的。对比前面客厅里的灯和下面这张抬头看的画面:吊灯跑到了画面角落,还有一部分出了画面。换了角度,物体在屏幕上的位置、大小、被挡住的部分都会变,这很正常。你要检查的是灯本身的结构有没有变。
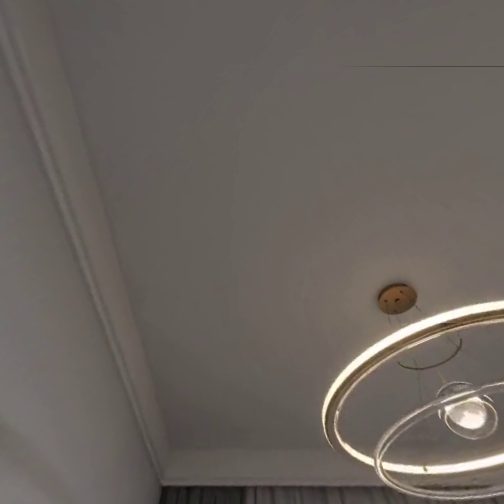
空间一致性是指换个角度看,同一个物体的形状、材质,以及它和周围物体的位置关系,都还对得上。
拿到一件能转着看的模型后,按这个顺序检查:
从正面转到侧面、背面。灯环连不连贯?支架有没有缺一截、或者戳进灯罩里?先解决这些破坏造型的大问题,再管小装饰。
挑一块花纹或一条接缝,转动时盯着它,看它是不是一直待在同一块表面上。再看金属、布料像不像你要的材质。注意,转动时反光的位置会跟着变,这是正常的;不正常的是材质本身变了,比如金属转着转着变成了塑料。
给寝室挑灯,灯罩和支架的比例合不合适?如果还生成了房间,灯和窗户、桌子的相对位置稳不稳定,家具摆放能不能正常使用?
还有两种容易和三维模型混淆的结果。一是全景图(Panorama):你站在原地转一圈能看到四周,但往前走一步、绕到沙发背后看,图里是没有的(见下图)。二是环绕视频:镜头绕着物体转一圈,但观众只能看,不能自己转。想让网页里的观众自己转、自己走,就要确认工具交出来的是真正的三维模型,而不只是图片或视频。
明天你会用 Lux3D 做第一件资产:上传一张图或写一段描述,它会生成一件能转着看的 3D 模型。现在先打开手机备忘录,写下你要做的东西:是什么、大概什么形状、什么材质、花纹在哪一面。比如:「一盏圆环吊灯,金属支架,只有外侧有条纹,背面是素色。」这就是你的设计要求,明天生成后就按它检查正面、侧面和背面。
03图像怎样从噪声里生成
如果你好奇「一句话为什么能变成一张图」,这一节用一个小实验带你看个大概。不懂这些原理,也完全不影响你用 Lux3D。
先猜一猜:滑块拖到一半时,你能从一片杂乱的画面里认出什么?拖动滑块或直接左右拖画面试试,也可以点 ▶ 自动播放。这个实验只是把一张预设的狗图和噪点按比例混合,用来演示「逐渐清晰」的感觉,并不是真实模型的生成过程。
噪点越少,狗的轮廓越清楚。真实的生成模型也是一步步把噪点「擦掉」,但每一步怎么擦,是它从大量图片里学来的。
这类模型叫扩散模型(Diffusion Model)。训练时,先给清楚的图片加上不同程度的噪点,让模型练习把噪点去掉;生成时,从一张纯噪点的图出发,按你写的文字一步步去噪,最后得到一张新图。
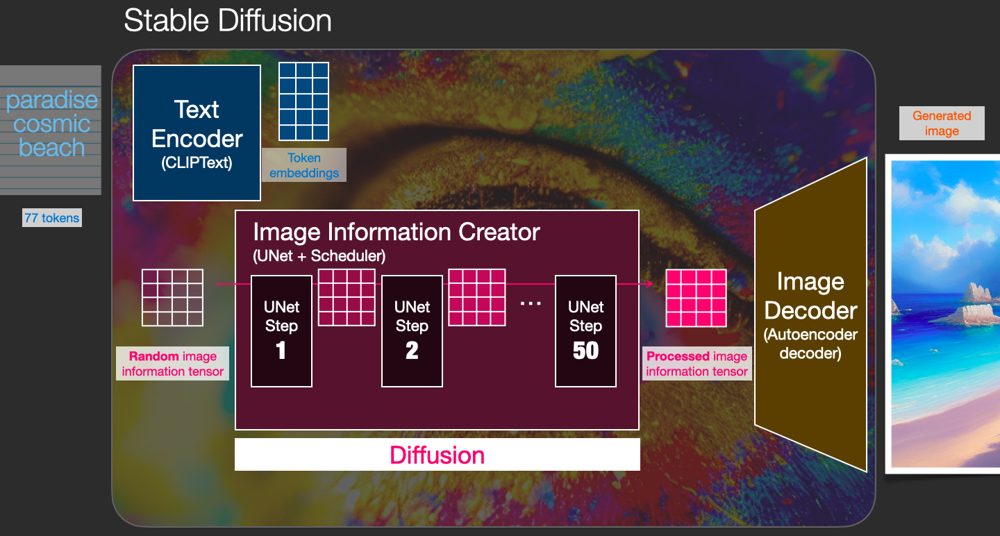
噪点里并没有藏着一张现成的照片等着被找出来,图是模型按学到的规律「画」出来的。所以换一个起点,结果就会不同。这也解释了上一节的问题:分别生成的两张图,里面的同一个物体不一定对得上,需要专门的方法保证空间一致。
04想让物体动起来,还需要什么
如果你想做的不是展示一盏灯,而是让观众按键推动物体,问题就多了:东西被推了怎么动?撞到墙会怎样?走开再回来,它还在不在原处?光看模型的外观,回答不了这些。
世界模型(World Model)想解决的就是这类问题:给它当前的场景和一个动作,预测接下来会发生什么。目前大致有三条路:
| 路线 | 怎样表达变化 | 与你选作品的关系 |
|---|---|---|
| 先生成三维场景,再渲染或模拟 | 创建三维内容;需要运动和碰撞时,再加入相应的模拟。 | 有了能看的模型,还要单独制作和检查交互行为。 |
| 交互式视频 | 根据已有画面和用户动作,继续生成后续画面。 | 操作感可以像游戏,但要另查是否交付你需要的三维资产。 |
| 隐式世界表征 | 在模型内部用紧凑的状态表示预测变化,不一定直接输出画面。 | 偏向预测与决策任务,不是拿到一个模型就能直接放进展示网页。 |
DeepMind 的 Genie 1 是交互式视频的例子:给它一张起始图(照片、手绘都行),你每按一次方向键,它就根据当前画面和你的动作生成下一帧。
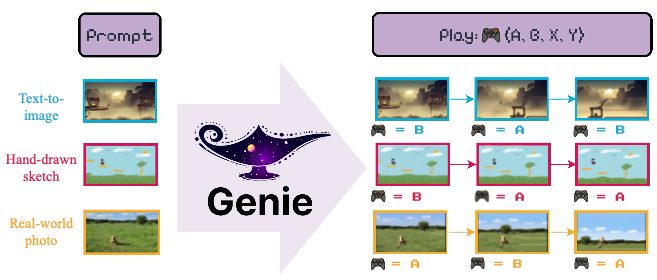
画面会动,还不代表它懂物理。要检查的是:按了键是不是真的有反应、反应对不对,把东西推走再绕回来,它会不会莫名其妙回到原处。这周如果你的目标是做一个能转着看的物件展示,先把资产和网页做出来就好,不必把这些加进第一版。