空间行动:机器人为什么还端不来杯子
想做「具身智能应用」方向的参赛作品,你可能会想到:让机器人听懂一句话,把杯子端过来。可五天里,你能做到哪一步?先分清走到目标、抓起物体和播放一段动画的区别,再决定自己的小作品要验证什么。
- 读完你能把「端杯子」拆成到达、抓取和执行后的检查。
- 读完你能说清机器人示范数据里,除了画面还要记录什么。
- 读完你能为一个房间导航小作品定下演示范围和完成标准。
01认出杯子,为什么还抓不稳
你让聊天 AI 看一张桌面照片,它可以指出杯子。但机器人要端杯子,还得知道杯子离夹爪多远、从哪边靠近、夹紧到什么程度。夹爪合上后,它还得确认杯子是否真的被拿起来。
空间行动是智能体在三维空间中执行物理动作的能力,包括导航、避障、抓取和放置。机器人通过身体感知环境、采取动作并与环境交互,是具身智能的一种形式。
端杯任务要不断重复下面三步。最后一步的结果,会影响下一次选择。
找到杯子,判断夹爪与杯子的相对位置。
让夹爪靠近,调整朝向,再尝试抓取。
杯子跟着夹爪移动了吗?滑落了,就要根据新状态调整。
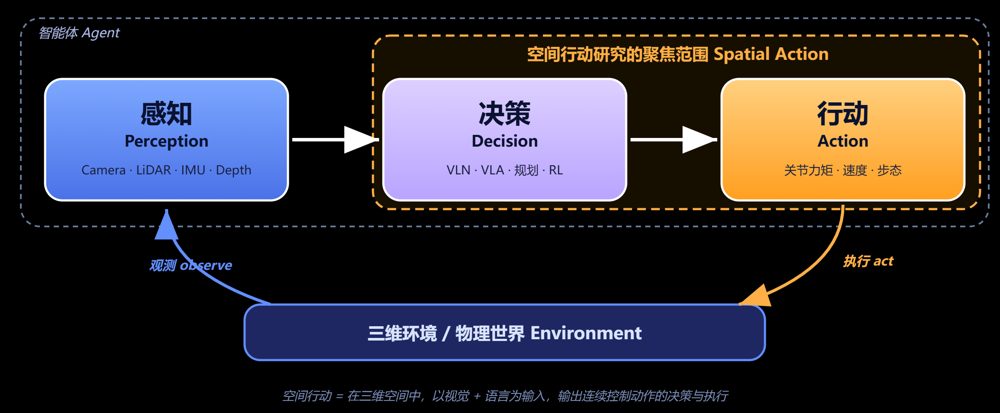
困难藏在动作里。夹爪到同一个位置,机械臂的多个关节都要配合;碰到杯子以后,摩擦和施力决定它能否抓稳。若任务变成叠衣服,布料还会变形,中途怎样判断「叠得更好了」也很难。
所以,这周别把「会认杯子」直接写成「会端杯子」。在你的演示里,分别展示它看到了什么、执行了什么、结果怎样。若物体只是沿预设路径移动,就把它标为动作动画。
02这周先做走到目标,还是抓起物体
「走到厨房冰箱前并停止」只要求到达;「把杯子拿起来」还要控制夹爪、处理接触。这是两种不同的完成标准。对第一次做作品的你,先选一个就够了。
| 你想演示的任务 | 机器人要输出什么 | 怎样算完成 |
|---|---|---|
| 走到目标前 | 前进、转向、停止,或连续速度指令。 | 到达约定位置,途中避开障碍并停下。 |
| 抓起并放好物体 | 机械臂与夹爪的控制动作。 | 抓稳物体,移动后放到指定位置。 |
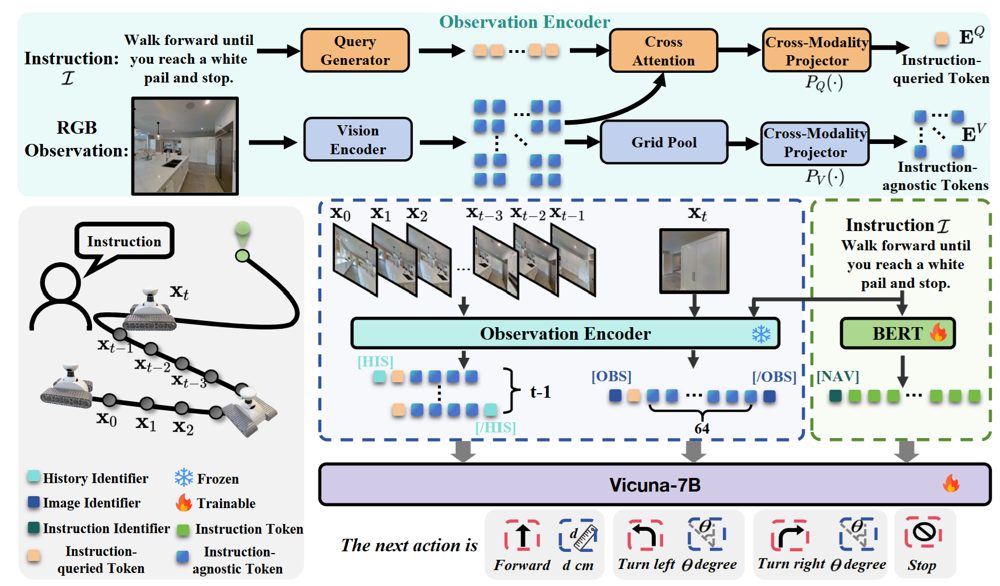
机器人接收语言指令与眼前的画面,逐步选择路线,这类任务叫视觉语言导航(Vision-Language Navigation,VLN)。它需要边走边看:转过门口以后,目标和障碍的位置都可能与刚才看到的不同。
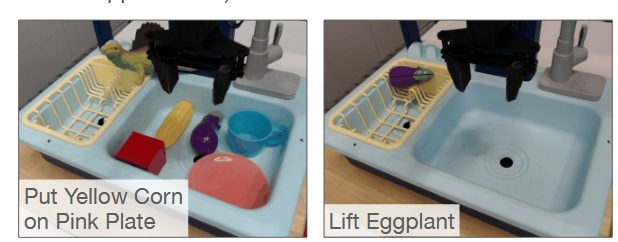
若输入图像和指令,输出抓取、放置等机器人控制动作,就会遇到视觉语言行动(Vision-Language-Action,VLA)模型。OpenVLA 是加州大学伯克利分校等团队开源的一个模型,下面的机械臂演示包括把玉米放上盘子、举起茄子。
如果你手头没有机器人和控制经验,可以把本周目标定成一个房间里的导航任务演示:有起点、目标、障碍和可查看的路线。Lux3D 可以用图片或文字生成作品里的 3D 物体;Aholo 可以把资产或场景放进网页供别人查看。路线如何计算、角色如何移动,要另外实现,不能把网页漫游当成机器人已经学会导航。
先固定一个目标,例如「走到冰箱前」。让别人看懂从哪里出发、为什么绕开桌子、最后停在哪里,比一次塞进「做饭、端茶、收拾厨房」更容易在五天里做完。
03为什么给机器人看视频还不够
你拍下自己端杯子的过程,画面里有手和杯子,却没有直接写出机器人每个关节该怎么转。训练机器人需要把「看到了什么」和「做了什么」对应起来。
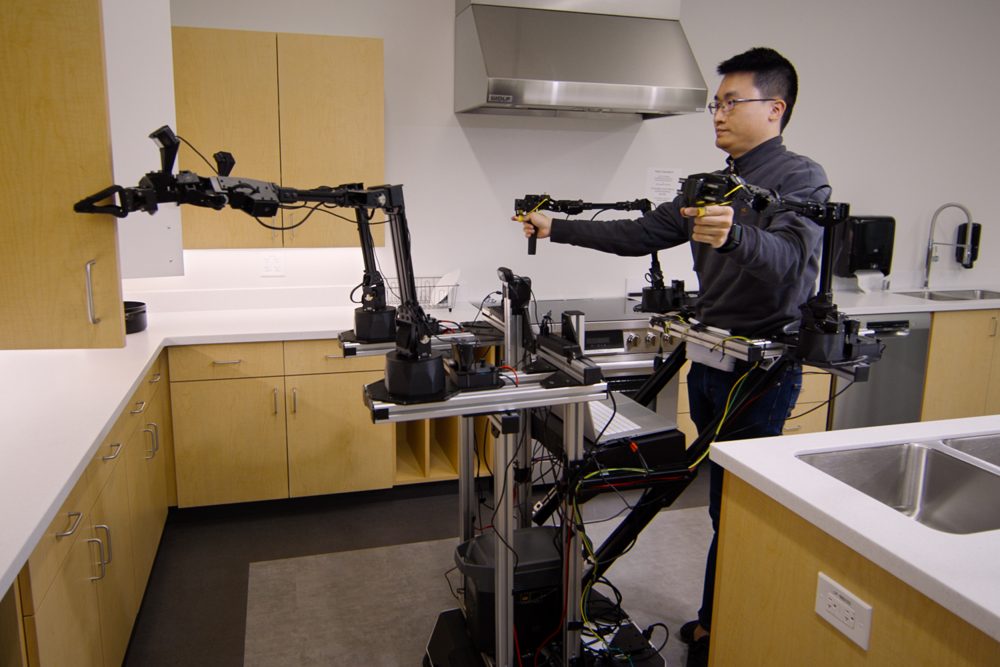
斯坦福团队的 ALOHA 系列用主从机械臂采集操作示范:人移动主臂,前方的从臂跟着执行。这样可以记录图像、关节运动等信息,让机器人学习某个状态下该采取什么动作。人通过设备操纵机器人,叫作遥操作(Teleoperation)。
随时间记录下来的位置、朝向或关节运动,叫作轨迹(Trajectory)。如果你的作品展示一条路线,就要说明它记录的是相机、虚拟角色还是机械臂。只画出夹爪经过的一条线,还没有描述抓取时的朝向和夹紧动作。
示范采集也要反复摆物体、操纵设备、检查记录。若你的选题需要大量自行采集的数据,先做一次算账,再决定五天里是否负担得起。
先猜一猜:采集条数翻倍,单条成本也翻倍,总成本会变成几倍?在下面分别拖动两个滑块(也可以直接拖绿色面积的右上角),看面积和总额怎么变。
总额就是「条数 × 单条成本」。假设采集 1000 条、每条 20 元,总计 20000 元;两项都翻倍,总计变成 80000 元。这些数字只用来练习算账,不是真实报价。
这个乘法提醒你:增加任务、物体和场景的变化,会带来更多数据需求。本周如果只是做导航任务展示,可以先使用自己明确编排的路线,并如实标出「预设路线」;无需为了演示去采集一套机器人训练数据。
04三维场景能帮机器人练什么
每次都在真实厨房里重新摆物体、采示范,很费时间。三维场景的价值就在这里:能改变物体位置、重放动作、查看碰撞,让机器人在虚拟环境里练习。同一个任务还能换成不同厨房,检查它是否只会在熟悉的布置中做事。
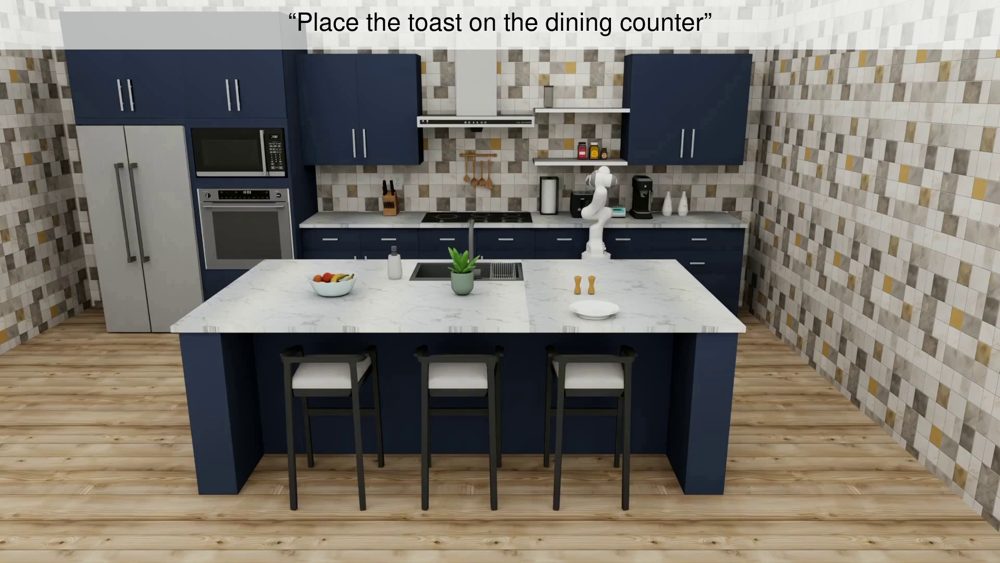
RoboCasa 是斯坦福与 NVIDIA 等团队构建的厨房仿真项目,可用于机器人操作任务。下图的任务是把吐司放到台面上。改变墙面材质,主要改变机器人看到的外观;挪动吐司或台面,则可能连原来的动作也要调整。
DemoGen 是一个利用已有示范合成新操作数据的研究项目。它的桌面插花示例中,花换到其他起点后,抓取和移动路径也跟着调整。这叫轨迹扩增(Trajectory Augmentation),目的是减少在每个新位置重新做人工示范的工作。
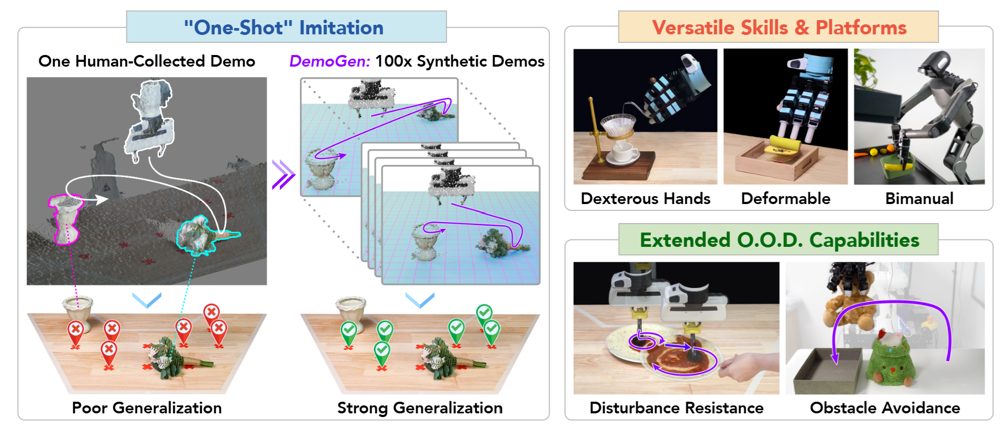
你本周可以借用这种「换位置再试」的办法检查作品:把导航演示里的桌子挪到原路线中间,观察角色是否穿过去。路线若只是固定动画,就会暴露这一点;若实现了避障,就要展示它怎样绕行或报告无法通过。
把房间做得逼真,就能当机器人训练环境吗?
还需要与任务对应的信息。导航要知道哪里能走、目标是什么;抓取还要处理物体形状、碰撞、摩擦和施力。漂亮的房间画面只解决了「看起来怎样」,你要为自己的任务补上可通行区域或碰撞等数据,再检查实际动作结果。
三维数据让机器人能在不同位置观察环境、找到目标,并检查动作会不会撞上东西;示范数据把观察和动作连起来。这也是为什么训练机器人需要的远不止一批好看的图片。
如果你选这个方向,就把交付缩到一个可查看的网页。准备一个房间、一个起点和一个目标,用 Lux3D 生成需要的物体,用 Aholo 展示资产或场景,再让 AI 编程工具帮你实现路线展示。
- 能看明白:访客能找到起点、目标和障碍,查看角色经过的路线。
- 能核对结果:检查角色有没有穿过桌子、是否停在目标前,保留一次失败情形和说明。
- 能说清做了什么:注明路线来自预设、寻路算法还是模型输出;若只有预设路线,不宣称自主导航或完成机器人训练。
先完成场景和路线展示,再考虑自动寻路。把仿真导航迁移到真实机器人,留作后续目标。
05自测:你的作品验证了什么
四题都已答对。接下来用 Lux3D 生成你的第一件 3D 资产。
下一课 →