项目实战:多智能体空间模拟
你想做一间会发生故事的 3D 房间:小人自己找门、搬东西,甚至捉迷藏。但五天后要交作品,第一步该让 AI 写什么?一位学员也从这样的大想法出发,最后做出了三个能在网页里演示的小场景。对你最有用的,是她怎样把第一步缩小,以及哪些地方花了力气却还没解决。
- 读完你能把一个大选题缩成有明确结束条件的小任务。
- 读完你能检查小人是否真的按观察结果行动,而不只是在播放动画。
- 读完你能分清哪些交给群核生成、哪些交给 AI 编程工具来写。
- 读完你能写出第一版需求,并请同学独立试一次。
01想做社会模拟,先让一个小人找到门
这位学员对人的社会行为感兴趣,也会用 AI 写代码。她想做一个三维实验台:让几个小人各自观察环境、选择行动,看看墙、家具和视野会怎样影响它们的选择。多个这样的角色在同一个环境里活动、相互影响,就是这里说的多智能体。
这个想法很大。她没有先造一座小镇,而是先做一间房、一扇门和一个小人。小人每轮只能得到自己眼前的画面,目标只有一个:走到门前,把门打开。
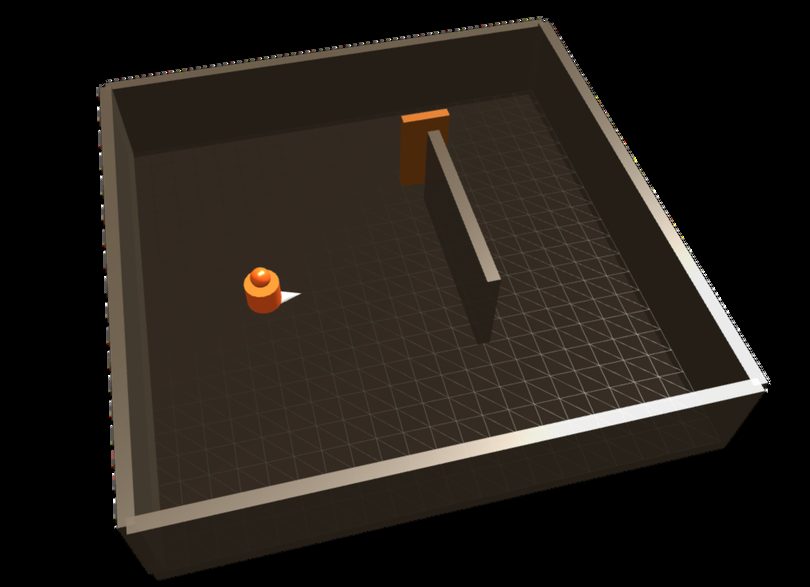
她只给小人前进、左转、右转、后转、开门和停留这些动作。要检查的事情也很具体:
模型拿到的是小人当前的位置与朝向所对应的画面。
例如向前走,或转身继续找门。
系统更新小人的位置,检查障碍;到门前才能执行开门。
下一轮要看到新位置、新朝向或已经打开的门。
如果模型说了「向前走」,小人却没动,第一版就还没完成。反过来,只要它能走到门前、打开门,过程可以重跑和查看,你就有了一段从开始到结束的演示。给自己的选题也写一句这样的完成标准,再让 AI 开始开发。
02怎么做出来:群核造场景和物件,AI 编程工具写玩法
想把这类模拟做成你的参赛作品,最省力的分工是:看得见的 3D 东西交给群核生成,让它动起来的规则交给 AI 编程工具来写。先把房间和物件做出来、存到本地,再让 AI 编程工具读这些文件,搭出能玩的网页小游戏。
打开 Aholo Reality:创建区的「AI 空间生成」页签可以从文字或参考图生成一间房;想用真实的房间,就在「重建」页签上传一段视频,做法见 3DGS 手机采集。生成或重建出的是 3DGS 场景,网页里用 Aholo Viewer 加载。
门、桌椅、小人这些单独的物件,在 Lux3D 工作台 从图片或文字生成,资产库里选 GLB 格式下载,放进同一个文件夹,比如 assets/。物件多时可以装 Lux3D 的 Skill 让 AI 批量生成,申请 key 和安装方法见 调用群核 Aholo API。
在 Claude Code、Cursor 这类工具里打开这个文件夹,让它加载资产,写移动、碰撞、视野和胜负规则。
为什么不让 AI 编程工具一起把东西画出来?它确实能用代码拼出一个方盒子房间、一个圆柱小人,但那只是几何体占位,看起来粗糙,一转视角就显得假。需要「看得见的 3D 东西」时,优先用群核的 API 生成:形状、材质和贴图都更完整,作品质量更好;比赛也要求 Lux3D 参与核心 3D 内容。AI 编程工具的力气,留给规则和交互。
资产准备好以后,可以这样交给 AI 编程工具(方括号里换成你自己的内容):
请根据 ./assets/ 目录下的群核 3D 资产,帮我生成一个网页 3D [找门] 小游戏。
资产说明:[room/ 是群核 AI 空间生成的 3DGS 房间,用 Aholo Viewer(npm 包 @manycore/aholo-viewer,文档 https://aholojs.dev/zh-CN/manual/getting-started/)加载;door.glb、table.glb、character.glb 是 Lux3D 生成的 GLB 模型,单位是米]。
玩法:[角色只能看到眼前的画面,自己绕过隔墙找到门并开门;玩家可以调整角色的视野]。
要求:
1. 场景和物件一律加载 assets 里的文件,不要用代码另画方块或圆柱来代替;
2. GLB 模型用 three.js 的 GLTFLoader 加载;读不到文档就问我,不要猜接口;
3. 给房间设置可走区域和碰撞,角色不能穿墙、穿家具;
4. 能开始、结束和重新开始。
先列出你打算怎么做和每一步怎么检查,等我确认后再写代码。
这样分工以后,作品里哪部分是群核做的、哪部分是你和 AI 写的,也就一目了然,写报告、做演示都好讲。
03跑通以后,再加哪一种玩法?
先试试:如果你看不到整张地图,找门会有什么变化?下面的格子世界里,三个探索者各记各的路,互相不通消息。
- 先猜:把可见距离扩大,三个探索者一定都会更快找到门吗?
- 保持初始的 2 格视野,点 ▶ 播放到三人都开门,记下每个编号旁的开门步数。
- 把视野拖到 6 格,再播放一次。点编号切到某个探索者的视角,看看它什么时候发现门,路径哪里变了。
文字版结论:同一间房、同一套移动规则,可见范围也会影响发现门的时机与路径。墙后仍要绕行。
规则没变,能看到的信息变了,路线就可能变化。如果你想把找门做成小游戏,可以把「调整视野,再看角色怎样走」作为第一版交互。先让使用者看懂这一处变化,不急着堆更多角色。
想做争夺玩法,就加资源和记忆
找门跑通后,学员做了资源争夺:红、绿、蓝三个小人各有一个家,中央放公共资源。每回合,它们可以采集、把资源搬回家、去别人家偷取,或留守防卫。
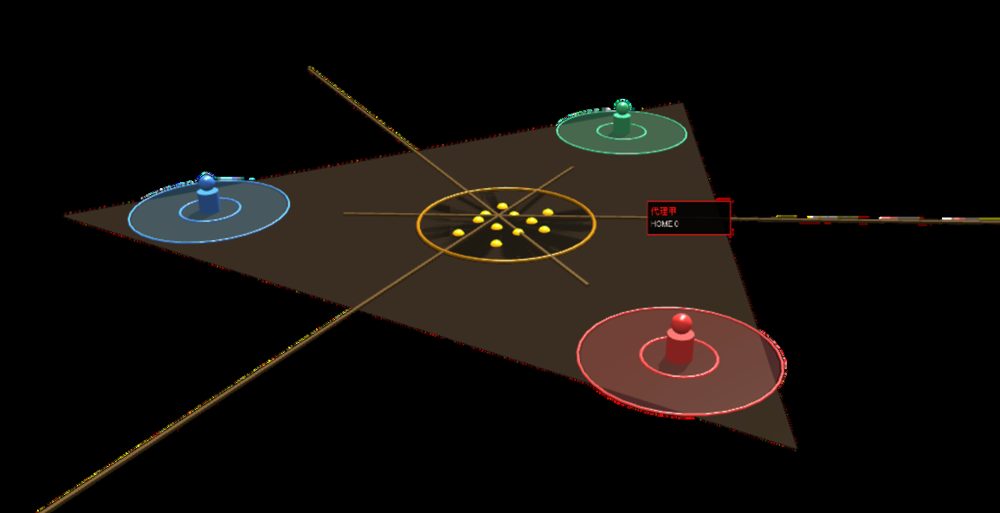
这里多了一种麻烦:小人记得「上次看见那里有资源」,但资源可能已经被搬走。它得结合当前画面和旧记忆行动。若你选这类玩法,至少检查一次:资源被拿走后,数量是否减少,下一次观察是否能发现变化。
想做追逐玩法,就加遮挡和时机
第三个场景是捉迷藏:红色小人寻找,蓝色小人躲藏。双方都没有全局地图,家具和朝向会制造盲区。
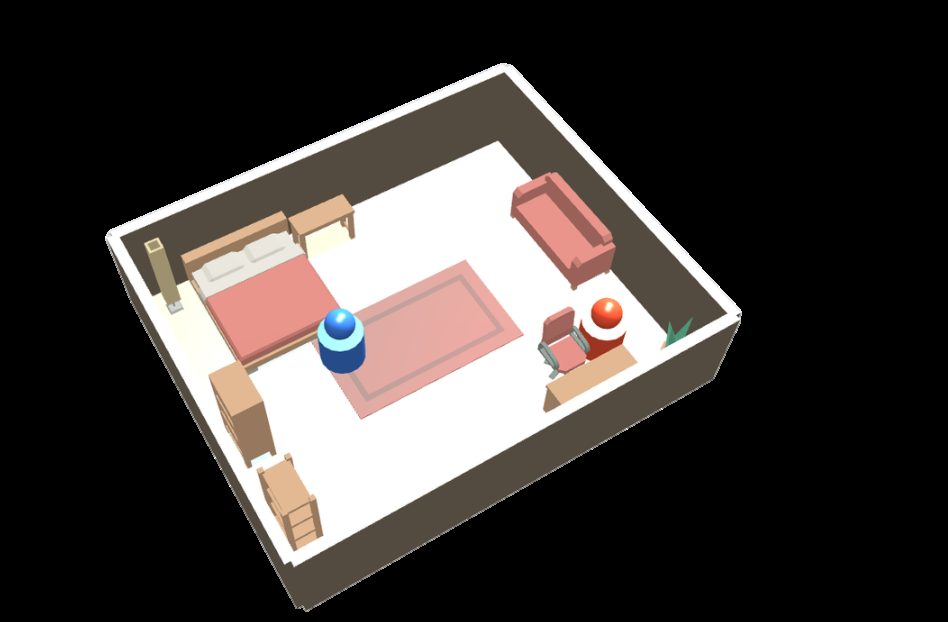
学员观察到,躲藏者有时会趁寻找者转身或距离较远时换藏点。这样的画面很适合展示作品的趣味,但比找门多了对手、遮挡和行动时机。你可以从三个玩法里选一个做小版本,不必把三种都做完才算作品。
04哪些坑会拖慢你的第一版?
房间看起来真实,小人却走不过去
学员当时的三个场景都是手工搭建的,把真实重建的房间接进来是后续计划。原因很直接:画面里有门、有地板,还得告诉程序哪里能走、哪里会撞、哪扇门能开。
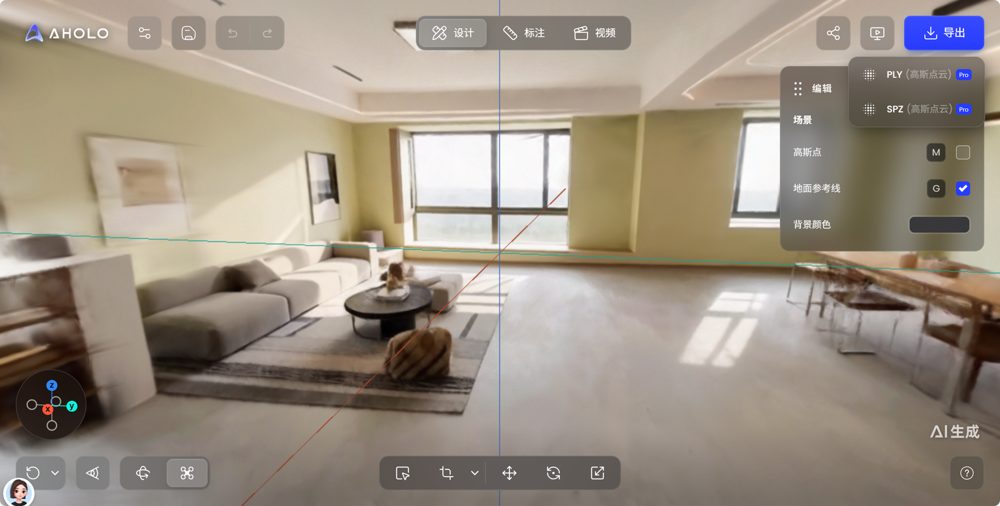
这张客厅图是场景库设想的示例,没有接入上述三个实验。你这周也可以先用简单房间验证移动,再换成更丰富的场景。若用 Lux3D 生成家具,它能帮你把图片或文字变成可转着看的 3D 模型;家具摆进去后,仍要检查碰撞范围和通道,别把外观完成当作玩法完成。
小人表现很好,却说不清为什么
学员有些版本给了角色太多信息,结果很好,却难以分清是模型判断出来的,还是系统已经给了答案。捉迷藏里也有鼓励冒险的人格提示和动态躲藏规则,换藏点不能直接算作模型自己想出了新策略。
演示自己的作品时,把两件事讲清楚就够了:角色能看到什么,哪些行动由规则规定。若要进一步声称「模型会利用盲区」,再保留输入画面、提示和实际动作,重复检查成功与失败的情况。五天内先做到能解释你的玩法,不必把作品包装成人类行为研究。
一个场景还没做好,就开始造平台
学员的找门、资源争夺、捉迷藏各有一套代码,换任务时又要开发。她后来计划把它们整理成可配置的通用引擎。这个问题确实存在,但对你的第一版,先保留一个场景和一个明确目标就够了。把「以后支持任意房间、任意玩法」放到待办里,别让它占掉交付时间。
05写清第一版,再请同学自己试
这位学员和 AI 协作时,会先写需求文档:为什么做、谁来用、本次做什么、不做什么、怎样算完成。方向变化时,她修改同一份文档,而不只是在聊天框里不断追加新想法。
如果你也想做找门小游戏,可以在 ChatGPT 或豆包里新建对话,填完方括号后发送下面这段。先请它检查范围;你确认后,再把需求交给正在使用的 AI 编程助手。
我要做一个能在网页里演示的 3D 找门小游戏。
给谁玩:[写一类具体的人,以及他为什么会想试]。
核心体验:使用者调整角色视野,看它能否绕过隔墙、找到门并开门。
本次只做:一间房、一扇门、一个角色;能开始、结束和重置。
本次不做:多人对战、复杂剧情、通用场景编辑器。
完成标准:角色按当前观察行动;到门前才可开门;动作后画面更新;能从相同起点重新开始。
展示材料:可操作页面,以及能看清角色观察、行动和结果的演示片段。
群核工具:[写你实际使用的工具、资产,以及它在作品里的用途]。
请检查这个范围里是否还有没说清的地方,列出最先要跑通的一步和验收办法。先不要写代码。
这是一份可改的作品需求示例。若你选资源争夺,把核心体验改成搬运与守家;若选捉迷藏,就写清怎样算发现、抓到或结束。群核工具也只写实际用到的内容,例如你用 Lux3D 生成了哪件家具,不把计划中的接入写成已经完成。
学员还发现,问朋友「这个作品好不好」很容易只得到「挺有意思」。更有用的是给他一个任务,先让他操作,观察在哪一步卡住。
你的第一版做好后,可以请一位同学「开始一局,调整一次视野,再重新开始」。先不代他操作,记下他停在哪里、没看懂什么、有没有发现路线变化。改掉最影响完成任务的一处,再试一次。能在你不站旁边讲解时玩完一轮,比再加一个没测过的新功能更值得优先做。
06自测
四题已答完。把你的想法缩成第一版,再去写选题卡。
下一课 →回头看,这位学员做对了三件事:第一版只要一个小人找到门,完成标准一句话就说清;看得见的房间和物件交给群核生成,规则交给 AI 编程工具写;能跑了就请同学自己玩一局,改掉最卡的那一处。
现在轮到你:写一句「谁来用、做什么、怎样算完成」,列出要用群核生成的一两样东西,带到从课程项目到参赛作品,整理成你的参赛选题卡。