Day 2 · 空间重建:把拍到的场景放进网页
你想做一个教室漫游网页,让同学在网页里走到讲台后面看看。用手机拍完视频交给重建工具,会得到点云、网格、3DGS 这些不同的结果。该用哪一种?先弄清它们各存了什么,再看能不能顺畅地放进网页。
读完你能:
- 分清点云、网格、体素、隐式场和 3D 高斯各自存了什么。
- 判断你的作品适不适合用 3DGS:只是看,还是要改形状、做碰撞。
- 给第 4 天的网页定一条浏览路线,检查哪里有缺块、手机上是否流畅。
01同一间教室,可以怎么存
想让访客在网页里换位置看,你需要一份三维场景。把拍到的照片、视频(有时还有激光测距的数据)还原成三维场景,叫空间重建(Spatial Reconstruction)。群核的 Aholo Reality 就能把你拍的素材重建成 3DGS 场景。
拿到结果后,先看它是用什么方式把空间存下来的。这叫空间表示(Spatial Representation),它决定了你之后能怎样显示、怎样修改这个场景。常见的有五种:
如果桌面被记成一堆带位置、带颜色的点,这是点云(Point Cloud)。点和点之间是空的,没有连起来。
如果这些点用三角面片连成了一张张表面,这是网格(Mesh)。有了表面,就方便在三维软件里改形状、配材质、贴图案。
体素(Voxel)把空间切成一个个小方格,像搭积木一样,哪里有东西就填上一格。格子切得越细,细节越多,要存的格子也越多。
隐式场(Implicit Field)不存点也不存面,而是训练一个神经网络把这个空间「记住」:你问它某个位置,它告诉你那里是什么颜色、是不是实心的。神经辐射场(NeRF)就是这一类。画面很逼真,但你很难直接拿它改形状。
3D 高斯(3D Gaussian)用成千上万个带颜色、半透明、可扁可长的小椭球,一起拼出桌椅和墙面的样子。它最擅长的是还原场景看起来的样子。
先猜一猜:点云里的点越来越多,会自己变成网格吗?在下面切换点云和网格,拖动桌子转一转,留意桌面边缘;再试试其他几种存法。
点云只记录采样点,网格另存面片连接;体素记录规则单元,隐式场通过函数查询属性,高斯记录带形状和外观的单元。增加点数不会自动生成面片。
怎么选?如果你的作品要改桌腿的形状,就需要网格这种带表面的结果;如果只是想把整间教室保留下来、让人走来走去地看,3DGS 最合适。
023DGS 适合漫游,不代表什么都能做
做教室漫游,你最在意两件事:墙面和桌椅看起来像真的;换个位置,画面能马上跟着变。这正是 3DGS 擅长的,所以它很适合把真实空间放进网页给人浏览。
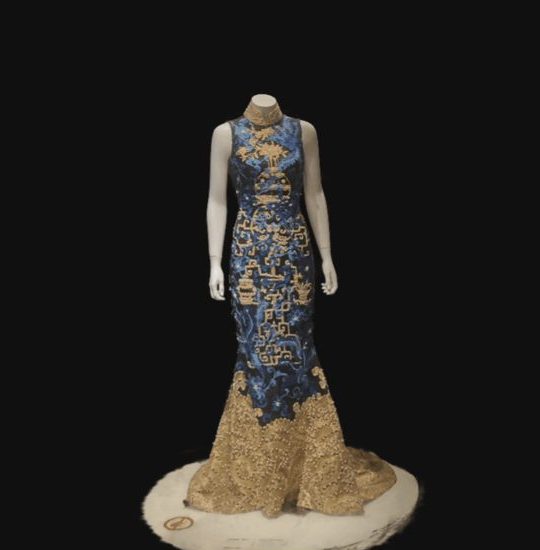
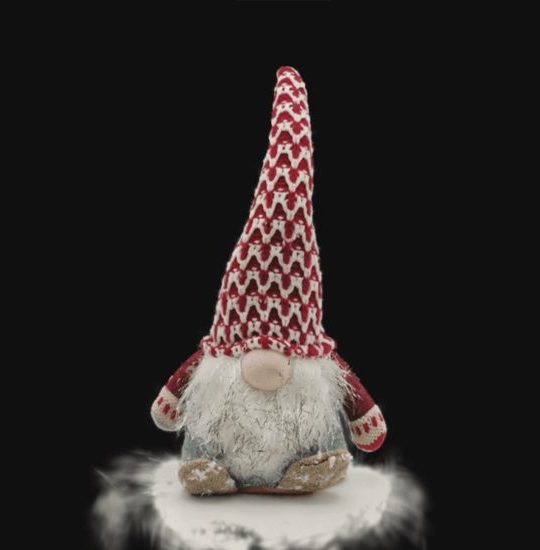
上面两件都是用 3DGS 还原的物体。光泽、绒毛这类细碎的外观,用传统建模很难做像,3DGS 却能保留下来。
3D 高斯泼溅(3DGS)把三维高斯单元投影到屏幕上,再按前后关系混合颜色,得到你当前看到的画面。
每个小椭球记着自己的位置、形状和朝向、颜色、透明度。你换一个位置看,它们投到屏幕上的位置和大小就跟着变,混出来的画面也就变了。下图的椭球只是示意,它们并没有硬邦邦的边界。
为什么能流畅?因为最费时间的一步已经提前做完了。重建时,电脑对照照片反复调整这些椭球;观看时,只是把调好的椭球投到屏幕上。你在网页里转动视角,浏览器并没有重新计算整个场景。第 4 天会用 Aholo Viewer 把这样的场景放进网页。至于在同学的手机上流不流畅,还是要拿真实场景试一试。
但如果你想让访客把一张桌子搬走,或者让游戏角色撞到桌子就停下,光有逼真的外观还不够。程序并不知道哪些椭球属于这张桌子,也不知道桌子的边界在哪。要整件搬动,得先把属于桌子的部分标出来;要做碰撞,还得另外给桌子配一个简单的几何外形。
所以五天里的第一版,先做到让人顺畅地看完一个固定空间。想加上搬家具、玩游戏,再把这些额外的工作列进计划。
03沿着访客的路线,检查重建结果
默认视角很好看,走到讲台后面却可能出现一个洞。重建只能还原拍到的东西,被挡住、没拍到的地方,就得换个位置补拍。
给你的教室网页先定一条短路线,比如从门口走到讲台旁,再转头看看桌椅。沿着这条路线检查,比停在默认视角放大看细节更管用:
走到桌边、讲台侧后方,找空洞、模糊的地方和飘在半空的碎片。缺的地方安排补拍;来不及补的,先不放进浏览路线。
从打开网页开始,试着转向、前进、靠近物体。电脑上能看,不代表同学的手机也流畅;卡的话,先缩小展示范围,或者换一个更小的场景文件。
请他从入口走到讲台,看会不会迷路、会不会走进有洞的地方。根据他卡住的地方,决定是补拍,还是加一句操作提示。
画面看着跟真的一样,可以直接拿来量尺寸、换灯光吗?
不行。量尺寸要先确认比例和误差,换灯光需要专门的材质数据,普通的重建结果都没有这些。如果你的作品只是展示空间,就先把浏览做好,别把它说成测量或装修工具。
今天给作品定下三件事:展示哪个区域、访客从哪里走到哪里、用哪台手机检查。想自己去拍,可以接着读选学的3DGS 手机采集,先拍好这一小块。
04为什么拍摄时要挪动位置
如果你准备自己拍教室,先做个小实验:伸出食指放在眼前,头不动,轮流闭上左眼和右眼。手指相对背景像在左右跳。两只眼睛的位置不同,同一个东西在两只眼里的位置也不同,这叫视差(Disparity),大脑就是靠它判断远近的。
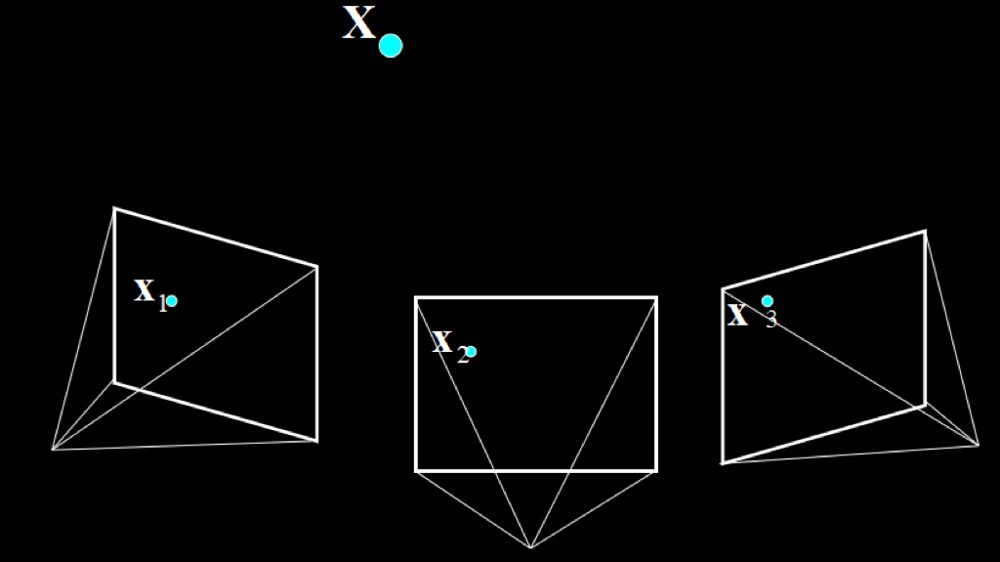
电脑也是这样算远近的:先在不同位置拍的照片里,找到同一个点(这一步叫匹配),再根据它在各张照片里的位置差算出距离。所以拍摄时要做到两点:相邻照片要有重叠的内容,电脑才找得到同一个点;拍摄位置要移动,才有位置差可算。只站在原地转一圈,电脑很难算出远近。
明暗也会让东西看起来有立体感,但电脑分不清一块暗的地方是阴影,还是本来就是深色。拍摄时别只追求单张照片好看,要让同一块表面在几个不同位置的照片里都拍得清楚。想知道相机是怎样成像的,可以读选学的 3D 视觉导论。
05传统重建怎样从照片走到表面
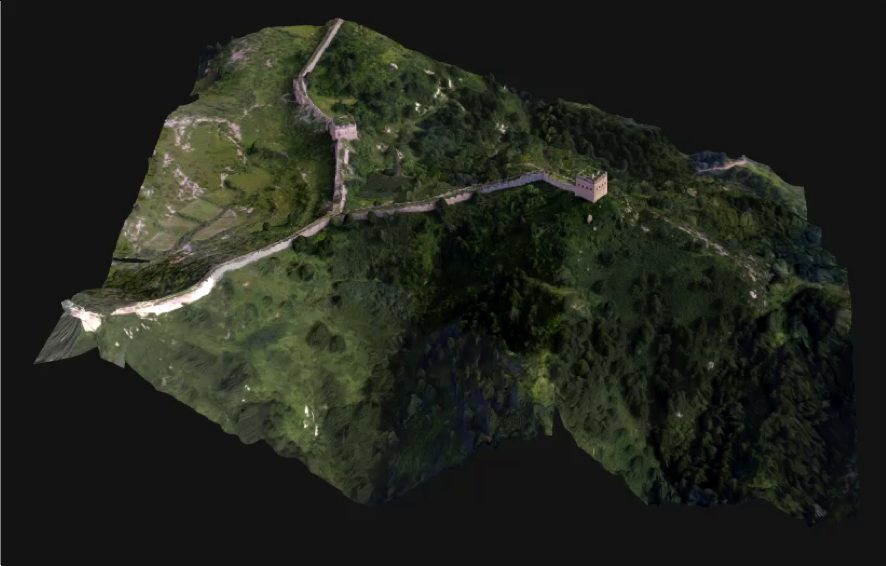
想知道重建为什么会缺一块,可以看看传统的重建流程是怎样一步步把信息补全的。下面是一段长城和周围山坡的重建:左图是算出来的拍摄位置和空间点,右图是最后还原出的地形和外观。
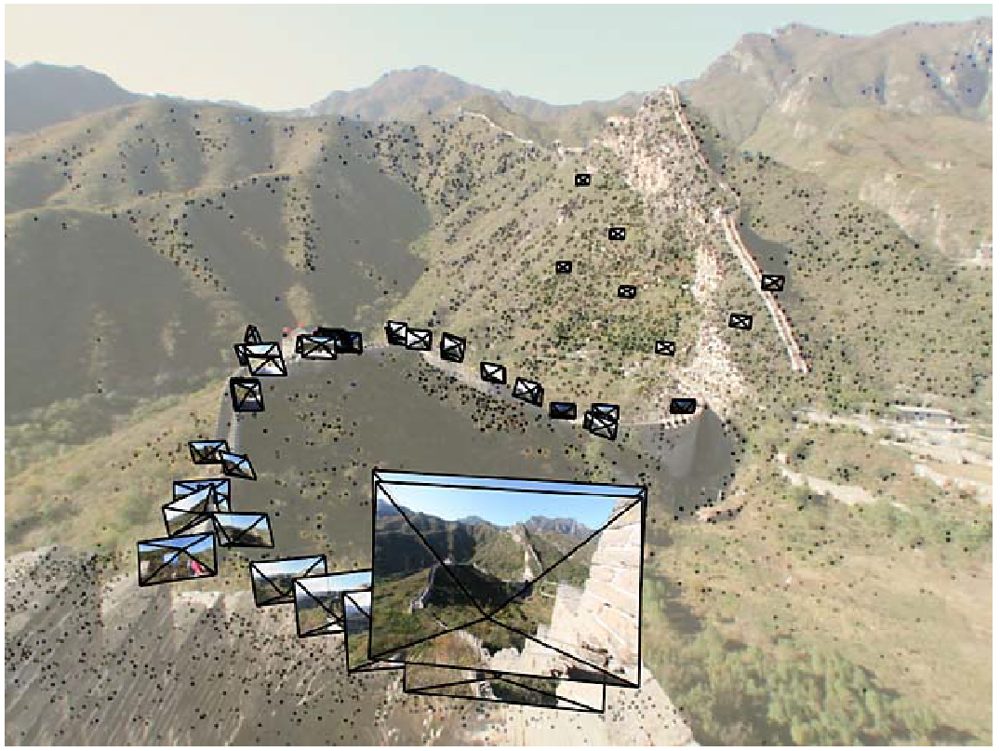
运动恢复结构(Structure from Motion)根据多张照片里的匹配关系,估计拍摄位置、朝向与少量可靠点的三维位置。位置和朝向合起来叫相机位姿。
多视图立体(Multi-View Stereo)利用相机参数和多幅图像估计更多深度,融合成稠密点云。点变密了,还没有自动连成面。
表面重建(Surface Reconstruction)根据点及其局部朝向等信息拟合表面,再把照片颜色映射上去,得到带纹理的模型。
白墙上没有花纹,电脑找不到可以对上的点;重复的图案容易对错;玻璃和反光的表面也很难算。重建结果缺了一块,可以按这个顺序排查:拍摄位置算对了吗?那块区域拍到的照片够不够?表面有没有足够的点来拟合?